AI 实践 AI PRACTICE · AI 教程
把几百页规程 PDF 变成会问答的知识库:RAGFlow 从零部署手记
运行规程、事故通报、设备说明书堆积如山,想用的时候却翻不到?RAGFlow 是一个专注深度文档理解的开源 RAG 引擎:解析、切块、检索、回答带引用。本文记录我在服务器上从零部署并跑通第一个知识库的全过程。
为什么需要知识库
电站运行年头久了,手里攒下的资料实在不少:运行规程、检修工艺卡、设备说明书、历年事故通报,加起来几百页起步。问题是真到要用的时候,谁也记不住某条规定到底在哪本册子的第几页——大多数时候靠问老师傅,老师傅再凭印象。
我一直想要这么一个东西:用大白话提问,它去翻这些 PDF,把答案找出来,还能告诉我是哪一页第几条。通用 AI 聊天机器人干不了这个——它没有你的资料,你把整本规程贴给它也不现实,还涉及资料外传。
RAGFlow 就是干这件事的开源项目:一个专注于"深度文档理解"的 RAG(检索增强生成)引擎。它在 GitHub 上有 9 万多 star,Apache 2.0 许可,国内团队开发,中文文档友好。它的特点是先把 PDF 版面分析、表格识别、OCR 做透,再切块入库,回答时给出处引用——这正对我的场景。
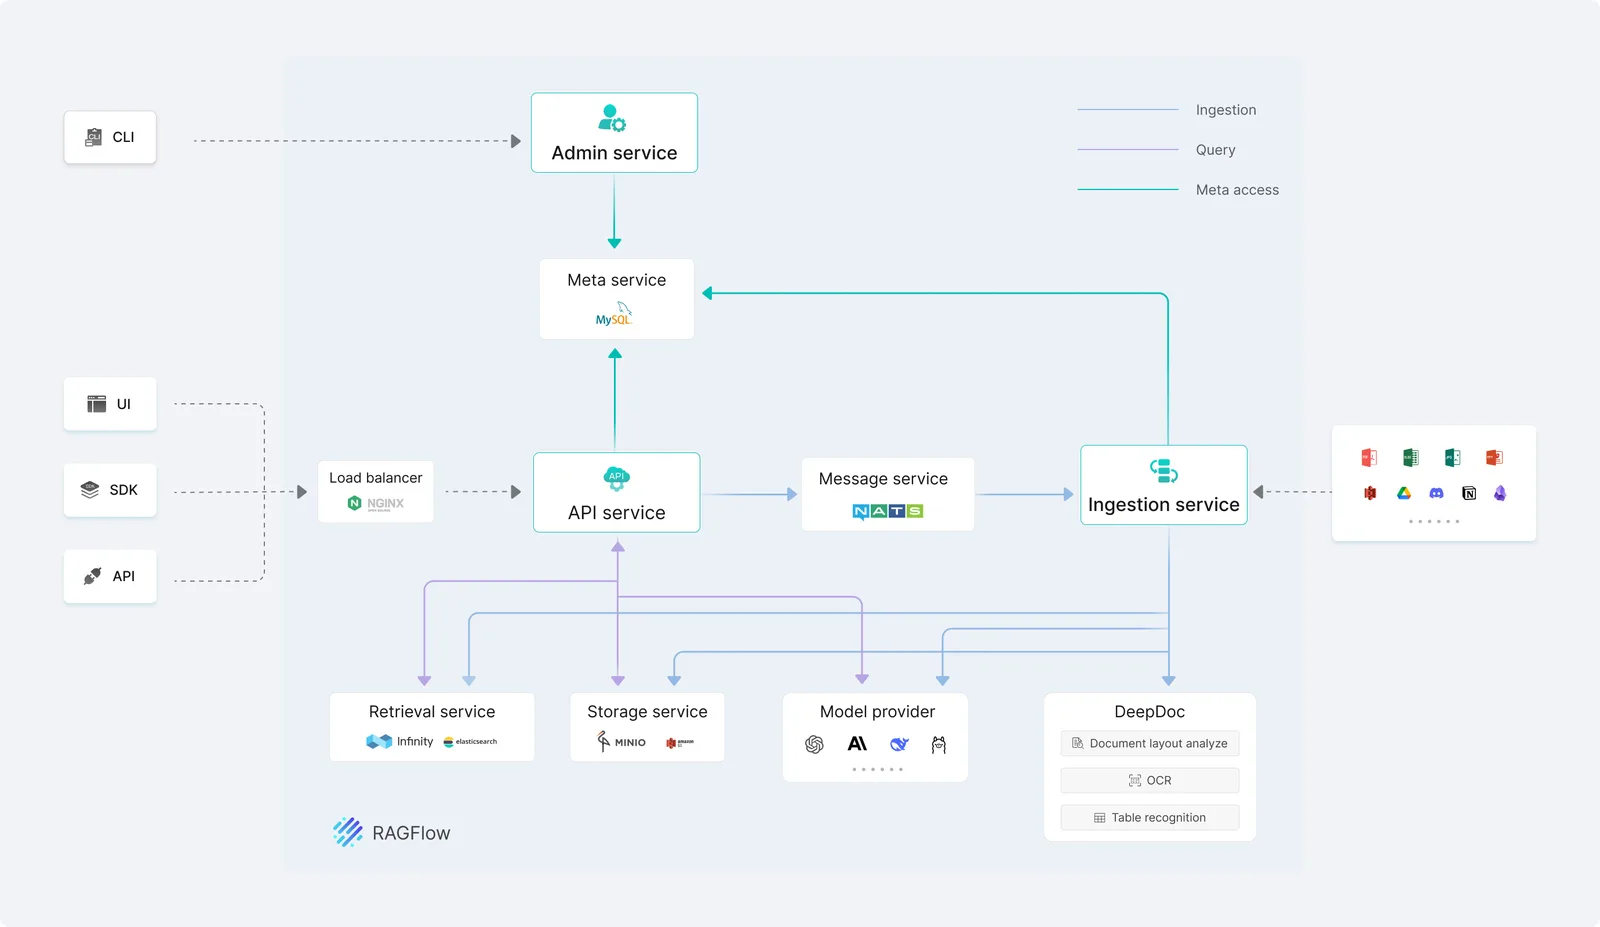
▲ 图 1:RAGFlow 系统架构(来源:RAGFlow 官方文档仓库 images/structure.jpg)
部署前的准备
先说清楚门槛,别白忙:
- 需要一台 Linux x86-64 的机器(官方明确 ARM64 暂不支持原生镜像),装 Docker 24.0+ 和 Docker Compose v2.26+;
- 建议 4 核 CPU、16 GB 内存、50 GB 空闲磁盘起;
- RAGFlow 本身不带大模型,需要你自己配一个模型服务的 API Key(也可以用 Ollama 接本地模型)。
内存不够的朋友可以到此为止,先看我的另一篇本地聊天方案。
三步把服务跑起来
官方文档的 quickstart 流程非常短,我照做一遍也就十分钟:
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/docker
# 按官方 quickstart 检出对应 release tag,再启动
docker compose -f docker-compose.yml up -d
有一个容易忽略的前置条件:默认用 Elasticsearch 做文档引擎,要求宿主机的 vm.max_map_count 至少 262144:
sudo sysctl -w vm.max_map_count=262144
国内网络的关键一步:镜像默认从 Docker Hub 拉,大概率超时。RAGFlow 在 docker/.env 里贴心地预留了国内镜像地址,把 RAGFLOW_IMAGE 一行换成阿里云或华为云的镜像(例如 registry.cn-hangzhou.aliyuncs.com/infiniflow/ragflow 加对应版本标签)就能顺下来。
启动后看一眼日志确认服务就绪,再做个健康检查:
docker logs -f ragflow-cpu
curl -f http://localhost/api/v1/system/healthz
返回 200 后,浏览器打开 http://<机器IP>(默认 80 端口,可在 .env 改 SVR_WEB_HTTP_PORT),注册管理员账号进系统。
上手实操:建库、传文件、开聊
进系统后右上角头像 → Model providers,把你用的模型服务 API Key 填进去并设为默认(Chat 模型和 Embedding 模型都要设)。然后回到顶部 Dataset 页签,Create dataset。
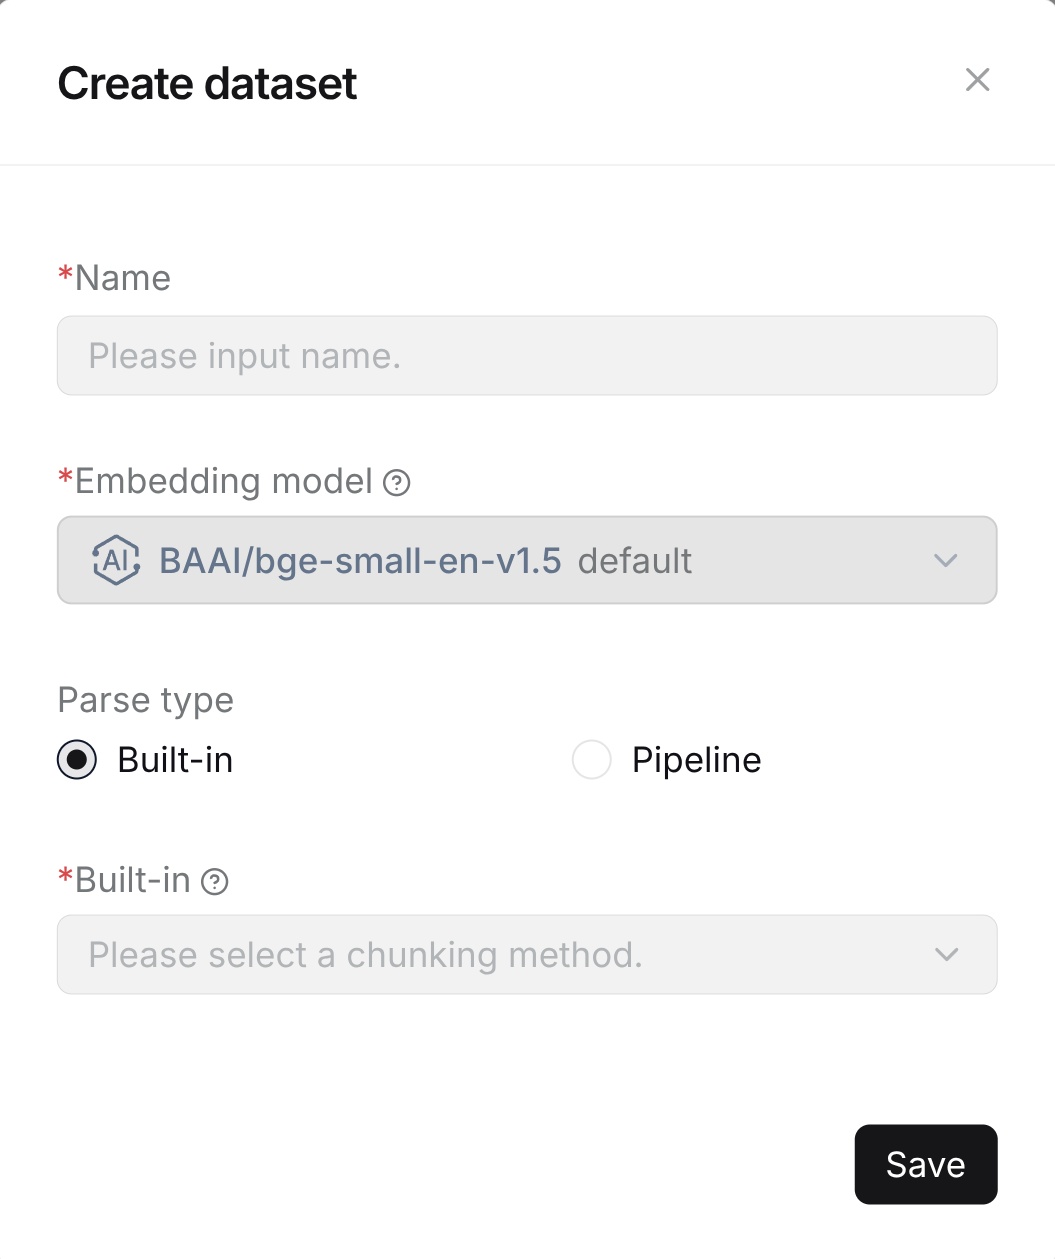
▲ 图 2:创建知识库(来源:RAGFlow 官方文档 quickstart 截图)
这一步有两个选项要留意:
- Embedding 模型:官方明确说,一旦用它解析过文件就不能再换,建库前先想好,建议选中文能力好的;
- 分块模板(chunk template):按文档类型选,说明书、论文、表格各有对应模板,选错会影响检索质量。
建好后 Add file 上传文件开始解析。官方支持的格式很全:PDF、Word、TXT、Markdown、Excel、CSV 乃至 PPT 和图片(走 OCR)都能吃。解析完点开文件能看到切块结果,不满意可以手动改,这也是 RAGFlow 比其他方案透明的地方。
▲ 图 3:文档解析分块演示(来源:RAGFlow 官方文档仓库演示动图)
最后是 Chat:新建一个对话助手,Model 选你配的 Chat 模型,Datasets 里勾上刚建的知识库,保存后就能问了。它回答时会附上引用片段,点引用直接跳到原文,"哪一页第几条"这个诉求就实现了。
用下来的体会是:答案质量七分靠文档解析,三分靠模型。切块切得碎、表格识别错,后面再强的模型也救不回来,所以解析那一步值得多花点时间检查。
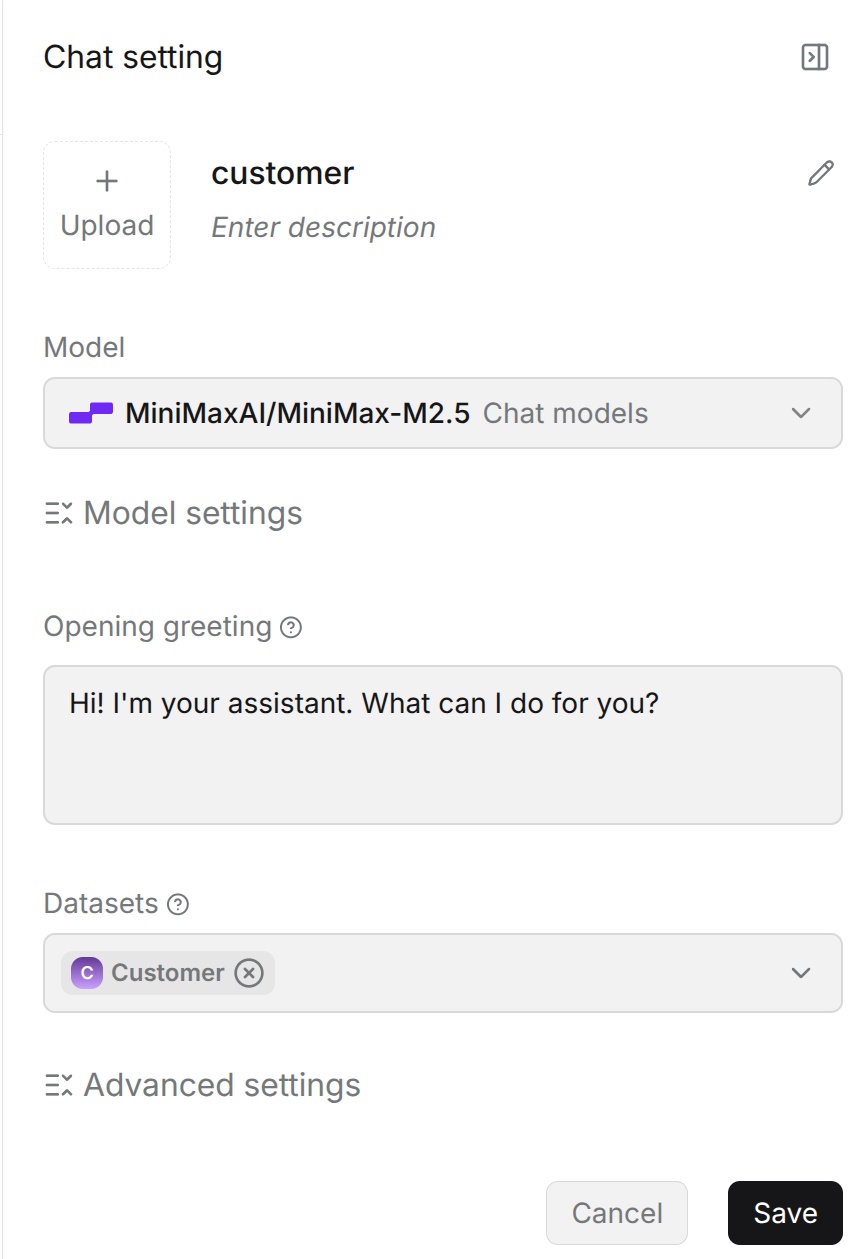
▲ 图 4:对话助手配置(来源:RAGFlow 官方文档)
进阶:让它替你跑流程
玩熟基础问答后,可以试它的模板化分块和手工干预:解析出的 chunk 可以逐个编辑、合并、禁用,把"这条被切坏了"修回去。再往上,RAGFlow 支持把检索、问答串成带逻辑的 agentic 工作流,官方仓库有完整演示——比如先检索规程,再根据条款生成处置建议的多步流程。
▲ 图 5:Agentic 工作流演示(来源:RAGFlow 官方仓库 README 引用的演示动图)
坑点提醒
- 别用 ARM 机器,装不上别硬来;手头只有 Windows 的话,建议在 WSL2 或一台小服务器上跑。
- 默认密码要改。
.env里 MySQL 等默认口令是公开写在仓库里的,要对公网开放前务必换强密码。 - 解析卡住先看日志:
docker logs ragflow-cpu基本能定位是文件本身还是模型调用的问题。 - 1.0 目前还是 rc 阶段,版本号和容器名(ragflow-cpu)以官方文档当时的 release 为准,升级前备份数据目录。
- embedding 选错只能重建知识库,没有后悔药。
总结
RAGFlow 把"几百页 PDF 变成会问答的值班手册"这件事做到了开箱即用:Docker 一把起,建库、传文件、配模型三步完事,回答带引用可回溯。对资料密集型的岗位,它能省下大量翻册子的时间。我的下一步是把事故通报和反措要求整理进去,再在班组里小范围试用,稳定后再写一篇复盘。
来源与修订说明
- 参考来源
- 灵感来源:RAGFlow(github.com/infiniflow/ragflow,Apache-2.0 许可)。部署步骤、配置项与界面说明已对照其 2026-10-17 时的官方 quickstart 文档核对。文中截图与演示图来自 RAGFlow 官方文档仓库,版权归原作者所有。本文为本站原创实操改写教程。
- 首次发布
- 2026-10-17 · 把几百页规程 PDF 变成会问答的知识库:RAGFlow 从零部署手记
- 最近修订
- 2026-10-17 · 首发。1.0 处于 rc 阶段,版本号与容器名以官方当时 release 文档为准。
- 更正说明
- 如发现技术性错误,请在评论区指出,确认后将在本区块登记修订记录。
0LIKE
当前为未登录状态:登录后即可点赞,登录后自动回到本页。
评论
0 条 · 先审后发评论在通过审核前,仅提交者本人可见;审核通过后对所有人公开展示。 当前为未登录状态,登录后可参与评论。
还没有通过审核的评论,来抢沙发。