AI 实践 AI PRACTICE · AI 教程
会议录音不出门变成文字稿:Whisper 本地语音转写手记
一小时会议录音从头听写要磨掉一个下午,而公网转写服务意味着把生产信息传上别人的服务器。Whisper 是 OpenAI 开源、MIT 许可的语音识别模型,整条转写流水线能在本机跑完。这篇记录安装的两个硬门槛、六种模型的取舍、中文转写的实测预期和校对技巧。
为什么想搭这个
站里开班会、搞培训,全程都有录音。以前要整理纪要,得戴着耳机一句句听写,一小时录音能磨掉一个下午。公网上有不少语音转文字服务,上传就能出稿,但会议纪要里全是生产信息,和聊天记录一样,我不想把它们丢给别人的服务器。Whisper 是 OpenAI 在 2022 年底开源的语音识别模型,GitHub 上 11 万+ star(截至 2026-10-17 是 11 万出头),MIT 许可,整个转写过程可以在本机完成,录音不出我的硬盘,这个场景它再合适不过。
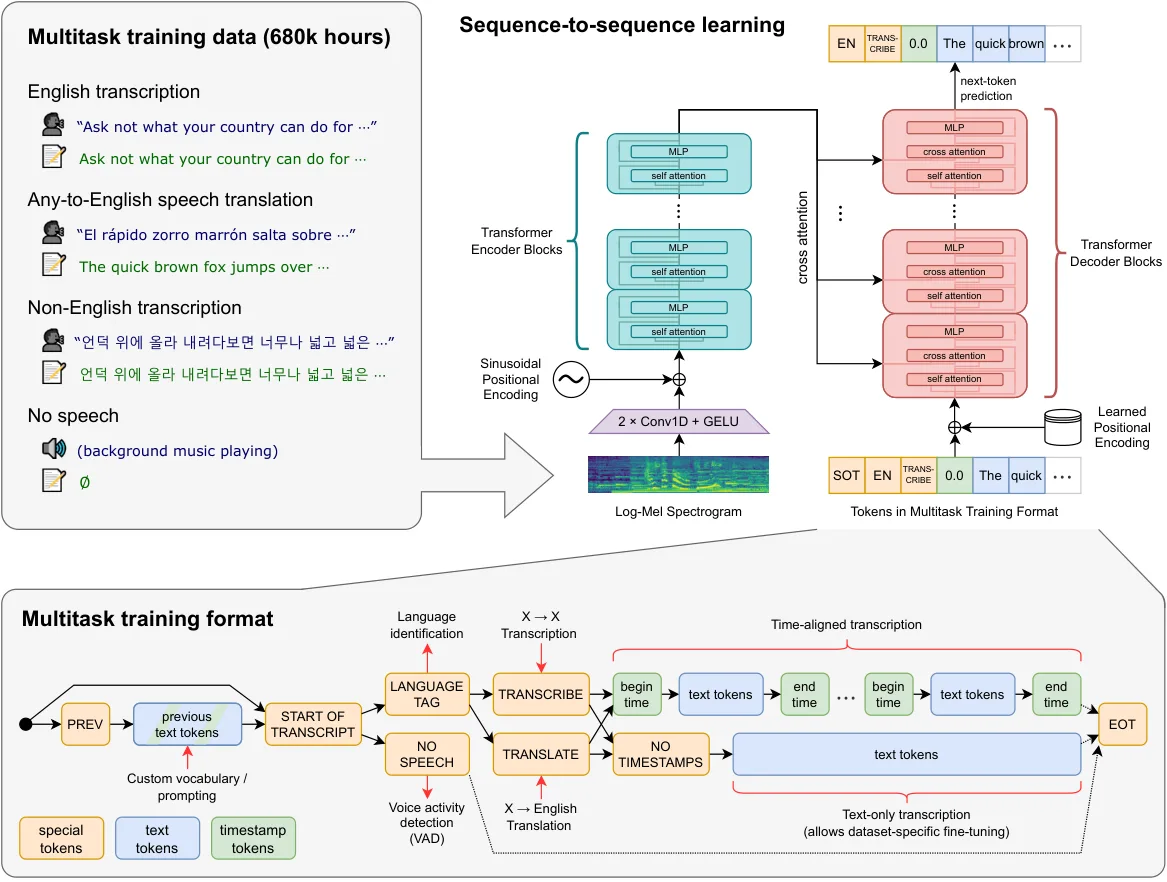
▲ 图 1:Whisper 模型结构(来源:Whisper 论文 arXiv:2212.04356 的 HTML 版插图)
安装:两条硬要求
Whisper 的安装命令只有一句,但有两个前置条件,卡人基本全卡在这:
pip install -U openai-whisper
第一,Python 版本必须是 3.8–3.11。 这是官方 README 明确写的兼容范围。如果你系统默认是 3.12/3.13,装依赖时会报编译错误(tiktoken 没有新版本的预编译轮子),这时候别硬刚,用 conda 或 venv 建一个 3.11 的环境再装。这是我踩过的第一个坑。
第二,系统里必须有 ffmpeg。 Windows 下官方 README 给的示例是 Chocolatey(choco install ffmpeg)或 Scoop(scoop install ffmpeg),winget 装也行,装完确认 ffmpeg -version 能跑通——它负责把 mp3、m4a 等各种格式解码成模型要的 16 kHz 单声道波形,没它寸步难行。
模型文件首次运行才下载,官方源在 openaipublic.azureedge.net,国内多数情况下直连能下,偶尔卡住重跑一遍基本就好。
跑通第一条转写
一条命令:
whisper 班会录音.mp3 --model small --language Chinese
它会自动识别成文字,并在当前目录输出一组文件:.txt 是纯文本稿,.srt 和 .vtt 带时间轴,正好做字幕和纪要定位,.tsv/.json 留给程序处理。整条流水线我画在图 2 里:ffmpeg 解码、切成 30 秒一段、提取 log-Mel 频谱、进模型、出文字,全程本机。
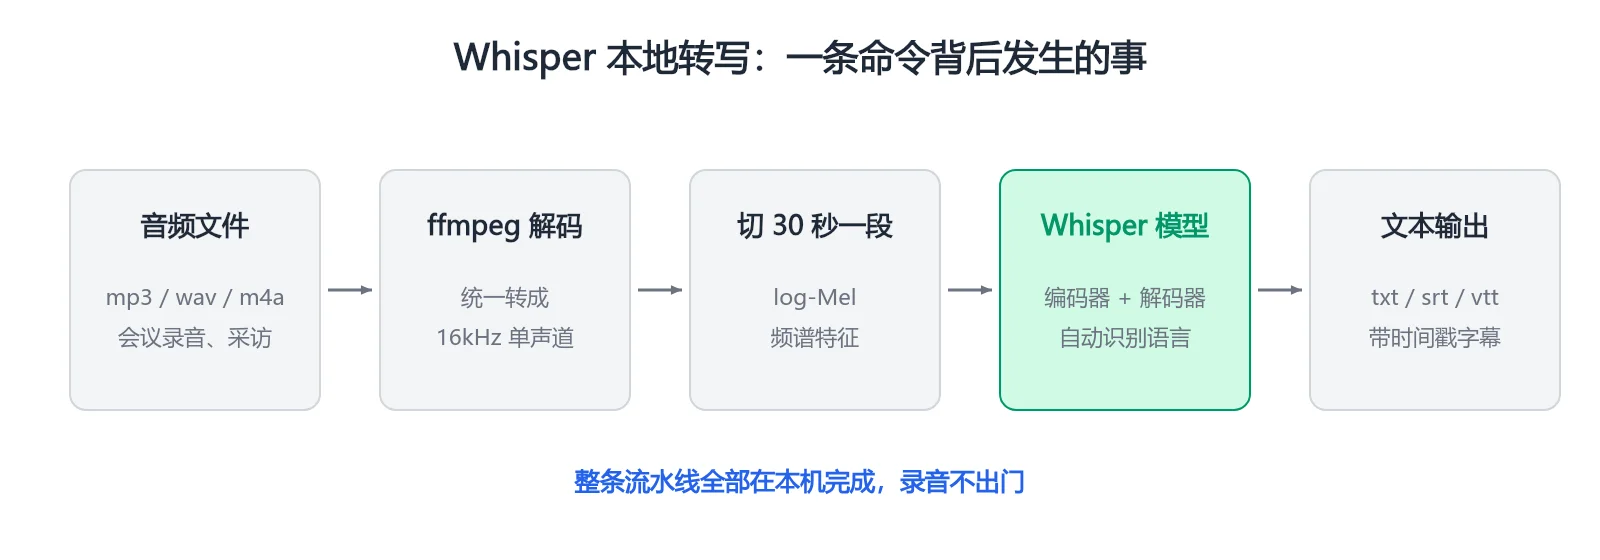
▲ 图 2:本地转写流水线(站长自绘)
模型怎么选
官方 README 给了六种规格,我把关键数据整理成图 3。实测感受:清晰的普通话会议录音,small 就基本可用;说话杂、术语多的场合换 medium 明显更稳;没有独显的机器用 tiny 或 base 先跑通流程再说。另外 README 有个细节:现在的默认模型是 turbo,它针对英文快速转写优化(比 large 快约 8 倍),但官方明确 turbo 不支持"翻译成英文"的任务,翻译场景要用多语言模型(small/medium/large)。
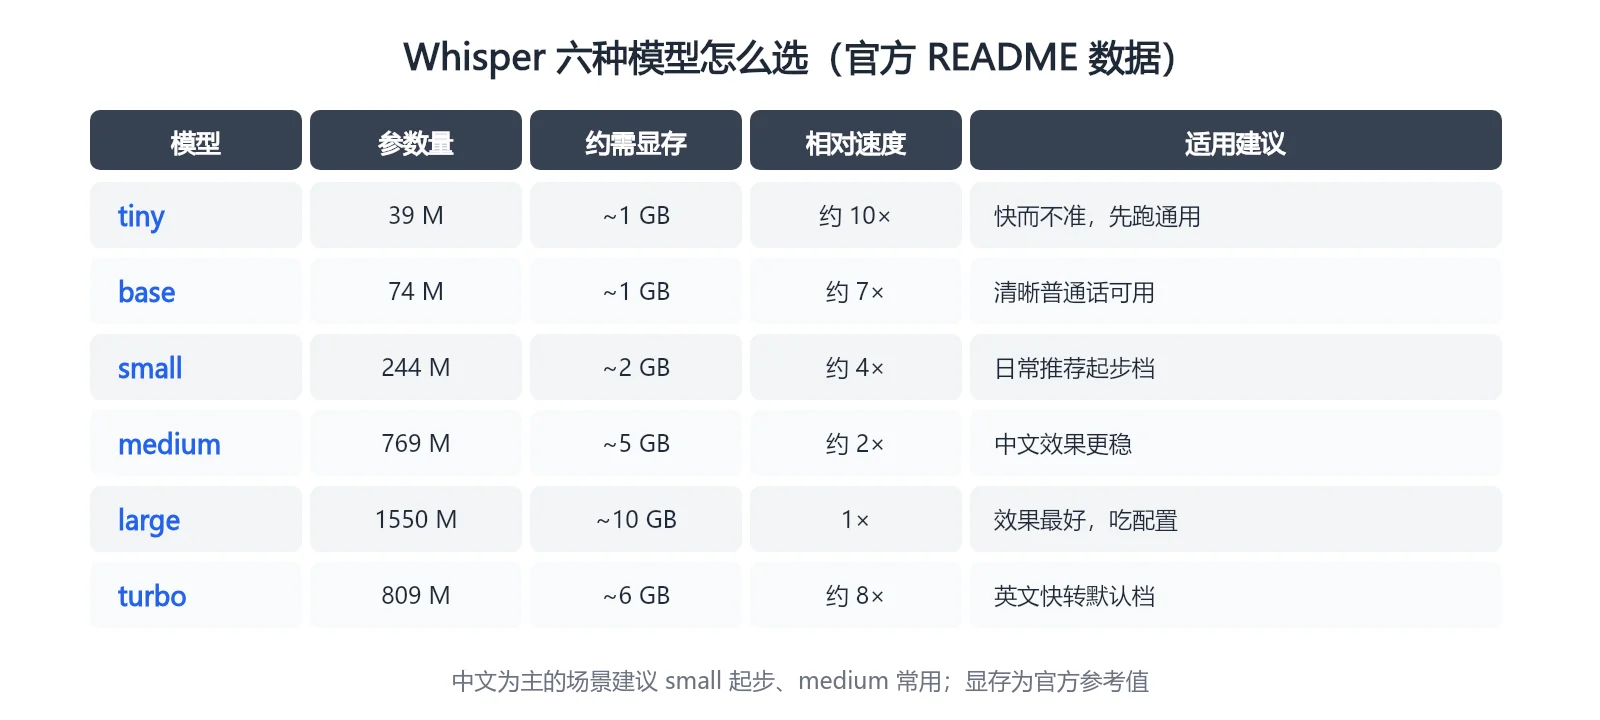
▲ 图 3:六种模型规格对照(站长自绘,数据来自官方 README)
图 4 是官方 README 里的多语言错误率图:普通话(Mandarin)在 large-v3 下错误率大约 12–13%,英语、西语这类在 5% 上下。对它的预期要合理——它能帮你完成"从录音到草稿"这最累的一步,但专业术语、人名地名务必人工过一遍,尤其是我们行业的设备编号,错一个数字性质就不一样了。
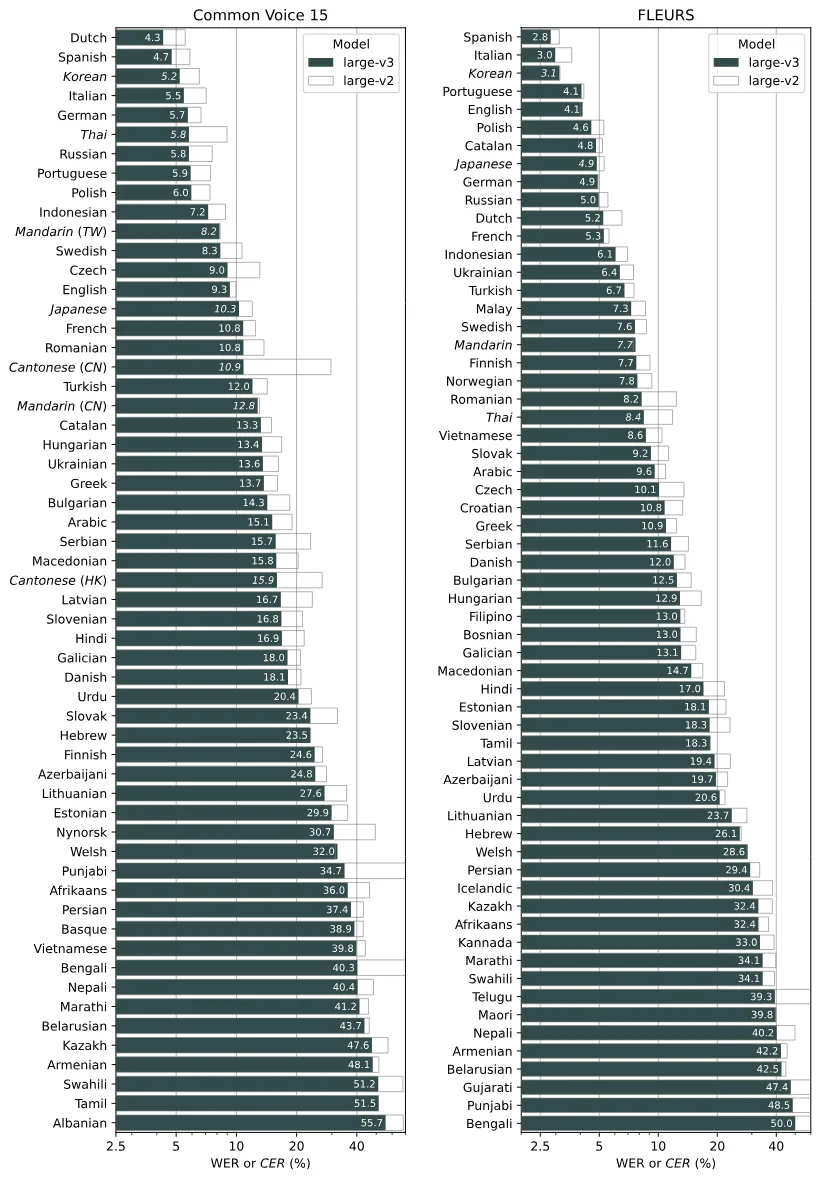
▲ 图 4:各语言识别错误率对比(来源:openai/whisper 仓库 README 插图)
进阶与替代
三个常用进阶:--task translate 把非英语直接翻成英文(仅限多语言模型);whisper --help 里有输出格式、温度采样等一堆参数;想在 Python 里调用就做 import whisper 按官方示例几行接入自己的脚本。
批量处理也顺手,一个循环把文件夹里的录音全转了(Git Bash 或 Linux 下):
for f in *.mp3; do whisper "$f" --model small --language Chinese; done
转完之后的校对,我的土办法是用带时间轴的 srt 对着原录音快放抽查:开头结尾各听五分钟,中间随机抽三段。术语集中的段落(设备名称、编号)全文必查。这样半小时内能处理掉两小时的录音,比从头听写省太多。
如果机器没有 N 卡、嫌官方 PyTorch 版慢,可以看 faster-whisper 这个项目(SYSTRAN 维护,CTranslate2 引擎),同样 MIT 许可,CPU 上快好几倍,API 基本兼容。选哪个取决于你的硬件,两者模型文件通用。
我踩过的坑
- Python 3.12 装不上:回到 3.11 的环境立刻顺了;
- ffmpeg 没进 PATH:命令行报找不到文件,重装 ffmpeg 或手动加环境变量;
- 长录音一次性转很吃显存:几小时的录音建议先按小时切段再转,或换 tiny/base;
- 偶尔出现复读机式幻觉:某段没声音被"脑补"出重复文字,转完扫一眼 srt 就能发现,删掉即可;
- 合规别忘:录别人的发言前要有告知,转写出来的纪要涉及生产信息仍按内部资料管理,工具解决了"外传"问题,管不管得住还得看流程。
总结
Whisper 是"本地小模型"里实用性排第一梯队的东西:装俩依赖、背一条命令,一小时录音几分钟出草稿,数据还不出机。配合 srt 时间轴,从"听写一下午"变成"校对半小时"。至此本站的本地 AI 工具箱又补上一块:Ollama 跑大模型、Whisper 转录音、Dify 出应用、n8n 出流程——下一篇写最后一块拼图:自托管的 AI 搜索引擎 Vane。
来源与修订说明
- 参考来源
- 灵感来源:Whisper(github.com/openai/whisper,MIT 许可)。安装要求(Python 3.8–3.11、ffmpeg、pip install -U openai-whisper)、六种模型规格(39M–1550M 与 turbo)、默认 turbo 模型及"不支持翻译任务"的说明、命令行参数,均对照 2026-10-17 时官方 README 核对(最新 release v20250625)。模型结构图来自 Whisper 论文 arXiv:2212.04356 的 HTML 版插图;多语言错误率图来自官方 README;流水线图与模型对照表为站长自绘。faster-whisper 为 SYSTRAN 维护的姊妹项目,同样 MIT 许可。
- 首次发布
- 2026-10-17 · 会议录音不出门变成文字稿:Whisper 本地语音转写手记
- 最近修订
- 2026-10-17 · 首发。模型与参数以上游当时 README 为准;对识别错误率的预期随版本与录音质量变化。
- 更正说明
- 如发现技术性错误,请在评论区指出,确认后将在本区块登记修订记录。
1LIKE
当前为未登录状态:登录后即可点赞,登录后自动回到本页。
评论
0 条 · 先审后发评论在通过审核前,仅提交者本人可见;审核通过后对所有人公开展示。 当前为未登录状态,登录后可参与评论。
还没有通过审核的评论,来抢沙发。