返回首页返回书籍《Hello 算法》
目录

目录 · CONTENTS

  1. 01序
  2. 02前言
  3. 03关于本书
  4. 04如何使用本书
  5. 05小结
  6. 06初识算法
  7. 07算法无处不在
  8. 08算法是什么
  9. 09小结
  10. 10复杂度分析
  11. 11算法效率评估
  12. 12迭代与递归
  13. 13时间复杂度
  14. 14空间复杂度
  15. 15小结
  16. 16练习
  17. 17数据结构
  18. 18数据结构分类
  19. 19基本数据类型
  20. 20数字编码
  21. 21字符编码
  22. 22小结
  23. 23练习
  24. 24数组与链表
  25. 25数组
  26. 26链表
  27. 27列表
  28. 28内存与缓存
  29. 29小结
  30. 30练习
  31. 31栈与队列
  32. 32栈
  33. 33队列
  34. 34双向队列
  35. 35小结
  36. 36练习
  37. 37哈希表
  38. 38哈希表
  39. 39哈希冲突
  40. 40哈希算法
  41. 41小结
  42. 42练习
  43. 43树
  44. 44二叉树
  45. 45二叉树遍历
  46. 46二叉树数组表示
  47. 47二叉搜索树
  48. 48AVL 树
  49. 49小结
  50. 50练习
  51. 51堆
  52. 52堆
  53. 53建堆操作
  54. 54Top-k 问题
  55. 55小结
  56. 56练习
  57. 57图
  58. 58图
  59. 59图的基础操作
  60. 60图的遍历
  61. 61小结
  62. 62练习
  63. 63搜索
  64. 64二分查找
  65. 65二分查找插入点
  66. 66二分查找边界
  67. 67哈希优化策略
  68. 68重识搜索算法
  69. 69小结
  70. 70练习
  71. 71排序
  72. 72排序算法
  73. 73选择排序
  74. 74冒泡排序
  75. 75插入排序
  76. 76快速排序
  77. 77归并排序
  78. 78堆排序
  79. 79桶排序
  80. 80计数排序
  81. 81基数排序
  82. 82小结
  83. 83练习
  84. 84分治
  85. 85分治算法
  86. 86分治搜索策略
  87. 87构建二叉树问题
  88. 88汉诺塔问题
  89. 89小结
  90. 90练习
  91. 91回溯
  92. 92回溯算法
  93. 93全排列问题
  94. 94子集和问题
  95. 95n 皇后问题
  96. 96小结
  97. 97练习
  98. 98动态规划
  99. 99初探动态规划
  100. 100动态规划问题特性
  101. 101动态规划解题思路
  102. 1020-1 背包问题
  103. 103完全背包问题
  104. 104编辑距离问题
  105. 105小结
  106. 106练习
  107. 107贪心
  108. 108贪心算法
  109. 109分数背包问题
  110. 110最大容量问题
  111. 111最大切分乘积问题
  112. 112小结
  113. 113练习
  114. 114附录
  115. 115编程环境安装
  116. 116一起参与创作
  117. 117术语表
  118. 118参考文献
  119. 119纸质书
第 80 / 119 节

第 80 节 · SECTION 80

计数排序

计数排序(counting sort)通过统计元素数量来实现排序,通常应用于整数数组。

简单实现

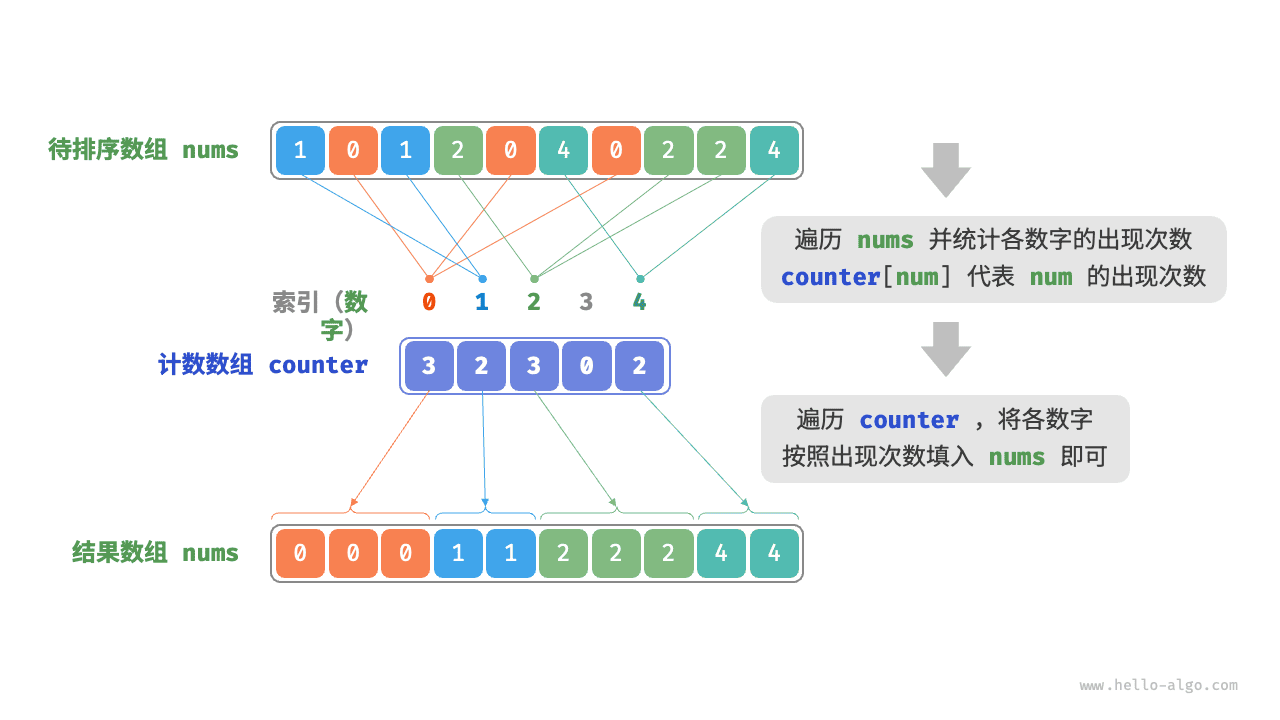
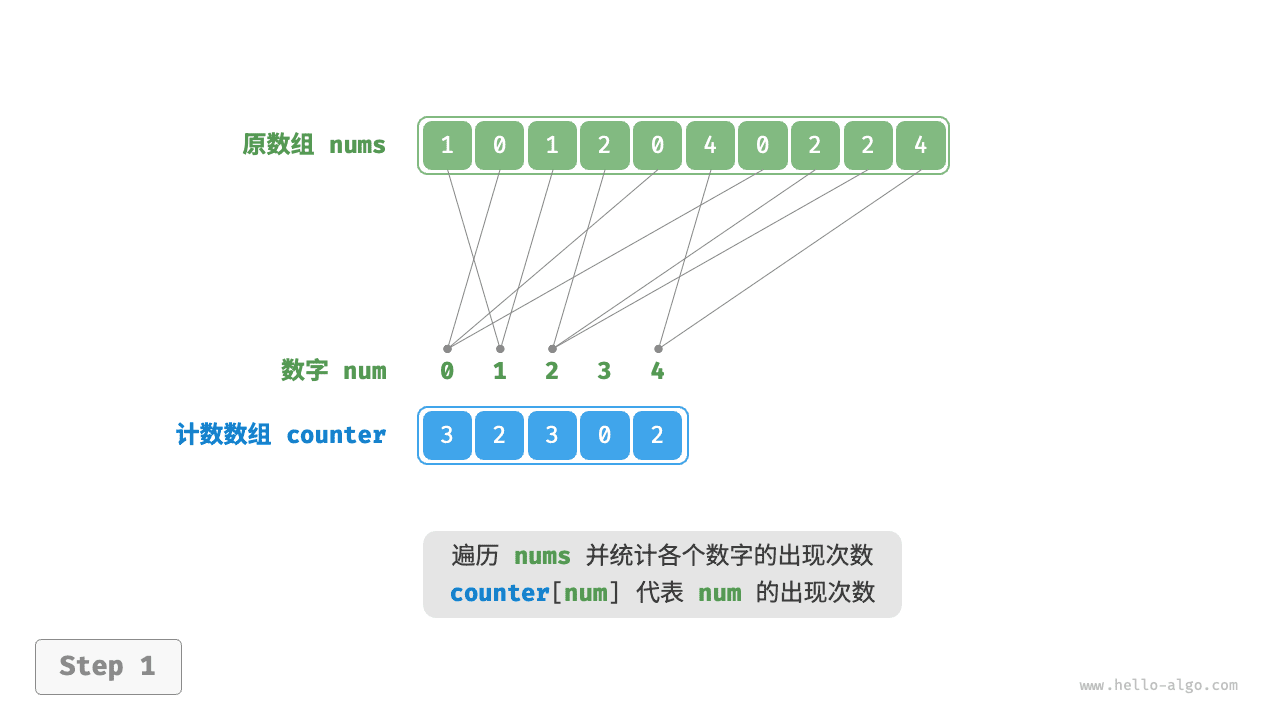
先来看一个简单的例子。给定一个长度为 $n$ 的数组 nums ,其中的元素都是“非负整数”,计数排序的整体流程如下图所示。

  1. 遍历数组,找出其中的最大数字,记为 $m$ ,然后创建一个长度为 $m + 1$ 的辅助数组 counter 。
  2. 借助 counter 统计 nums 中各数字的出现次数,其中 counter[num] 对应数字 num 的出现次数。统计方法很简单,只需遍历 nums(设当前数字为 num),每轮将 counter[num] 增加 $1$ 即可。
  3. 由于 counter 的各个索引天然有序,因此相当于所有数字已经排序好了。接下来,我们遍历 counter ,根据各数字出现次数从小到大的顺序填入 nums 即可。

计数排序流程

代码如下所示:

[file]{counting_sort}-[class]{}-[func]{counting_sort_naive}

!!! note "计数排序与桶排序的联系"

从桶排序的角度看,我们可以将计数排序中的计数数组 `counter` 的每个索引视为一个桶,将统计数量的过程看作将各个元素分配到对应的桶中。本质上,计数排序是桶排序在整型数据下的一个特例。

完整实现

细心的读者可能发现了,如果输入数据是对象,上述步骤 3. 就失效了。假设输入数据是商品对象,我们想按照商品价格(类的成员变量)对商品进行排序,而上述算法只能给出价格的排序结果。

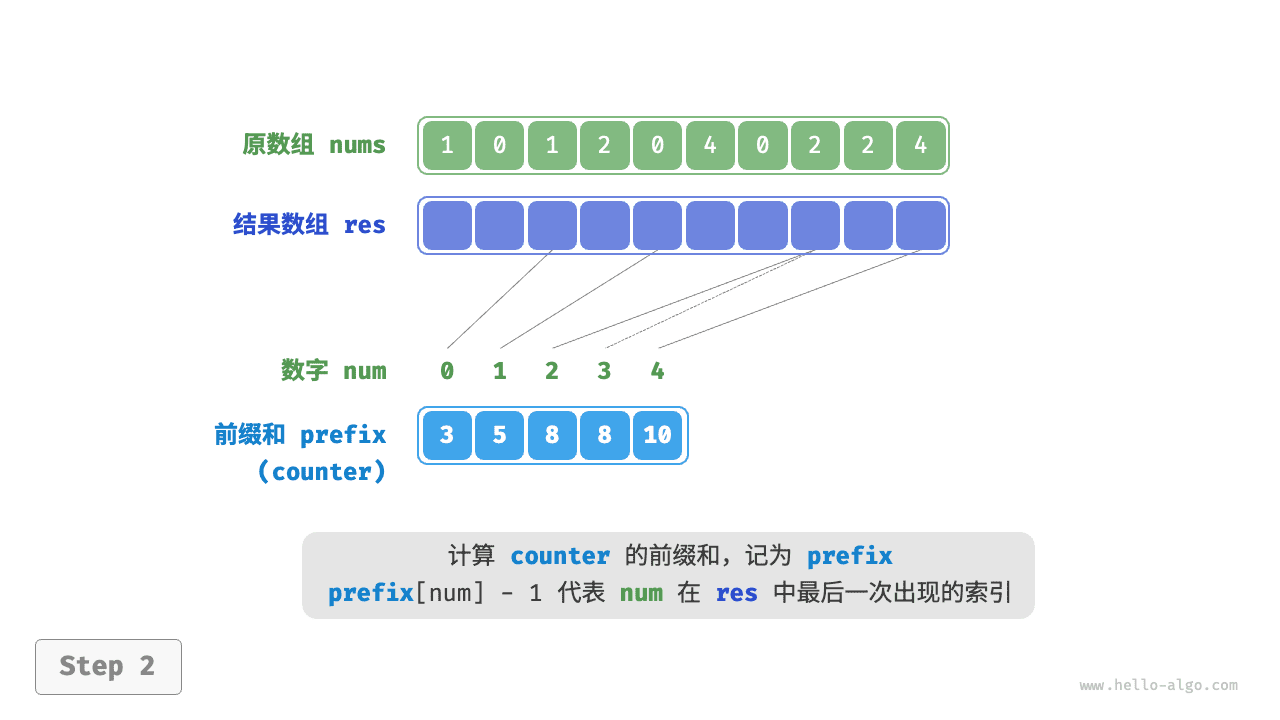
那么如何才能得到原数据的排序结果呢?我们首先计算 counter 的“前缀和”。顾名思义,索引 i 处的前缀和 prefix[i] 等于数组前 i 个元素之和:

$$ \text{prefix}[i] = \sum_{j=0}^i \text{counter[j]} $$

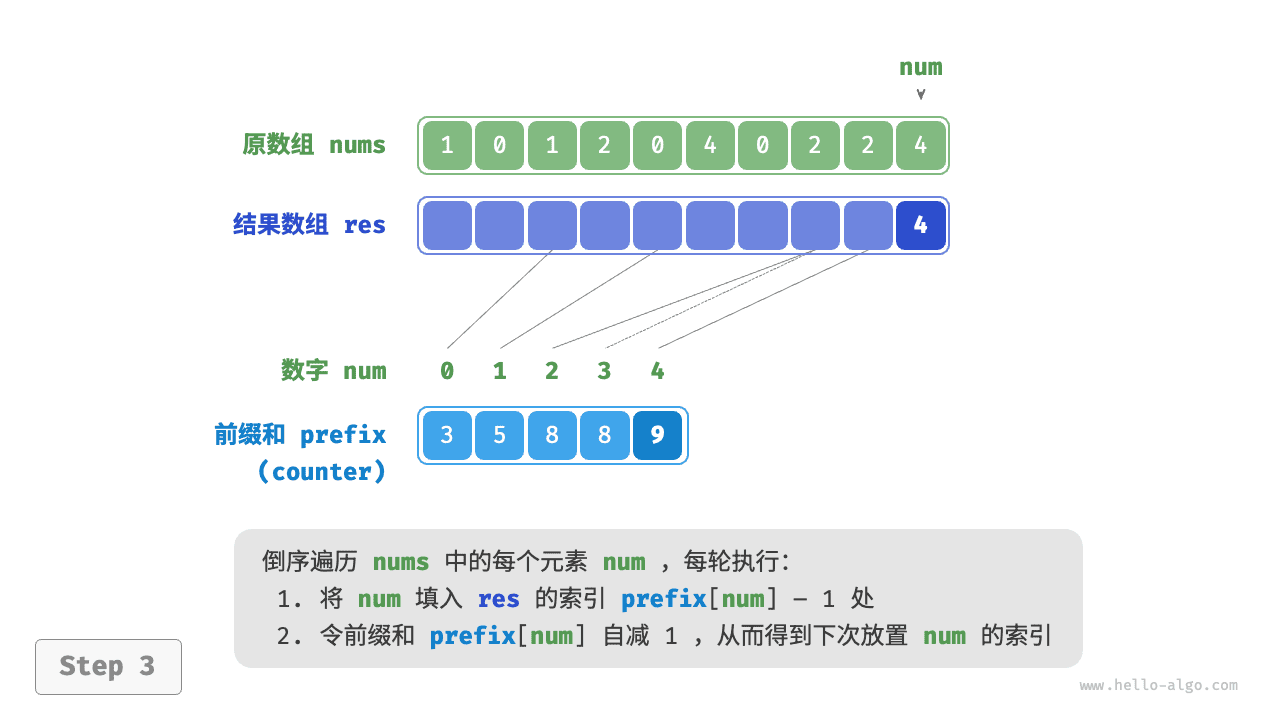
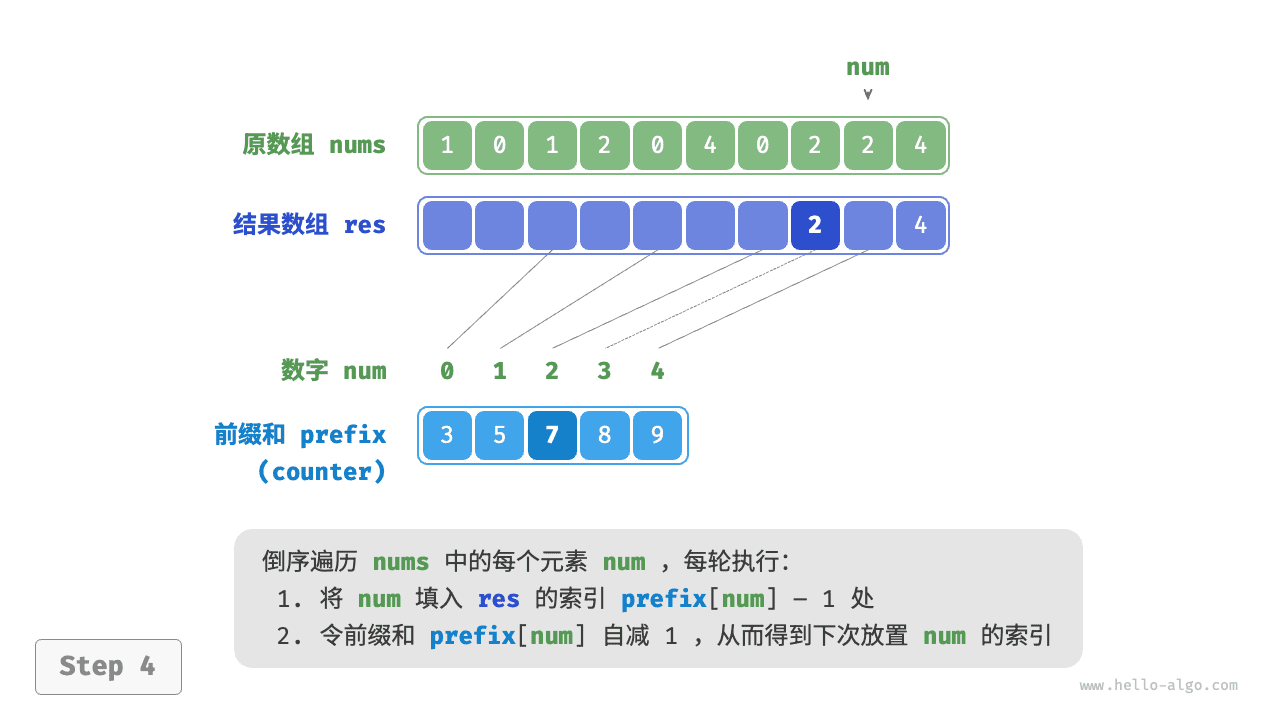
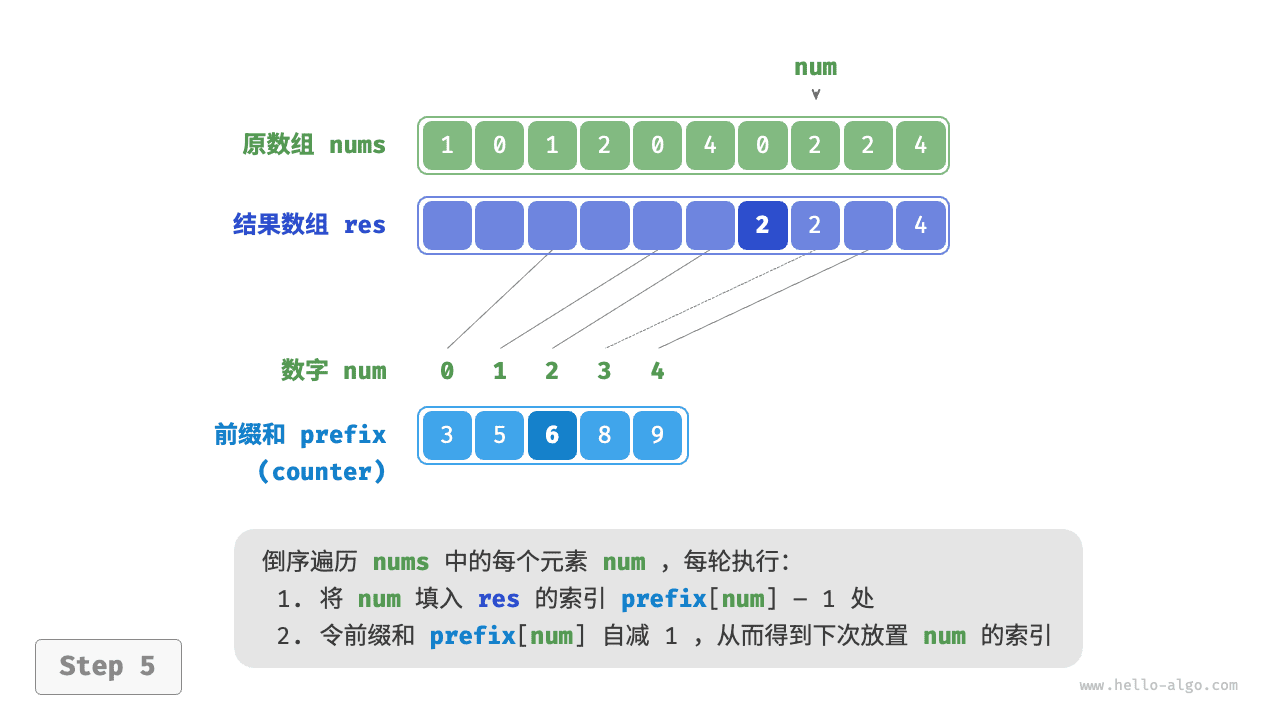
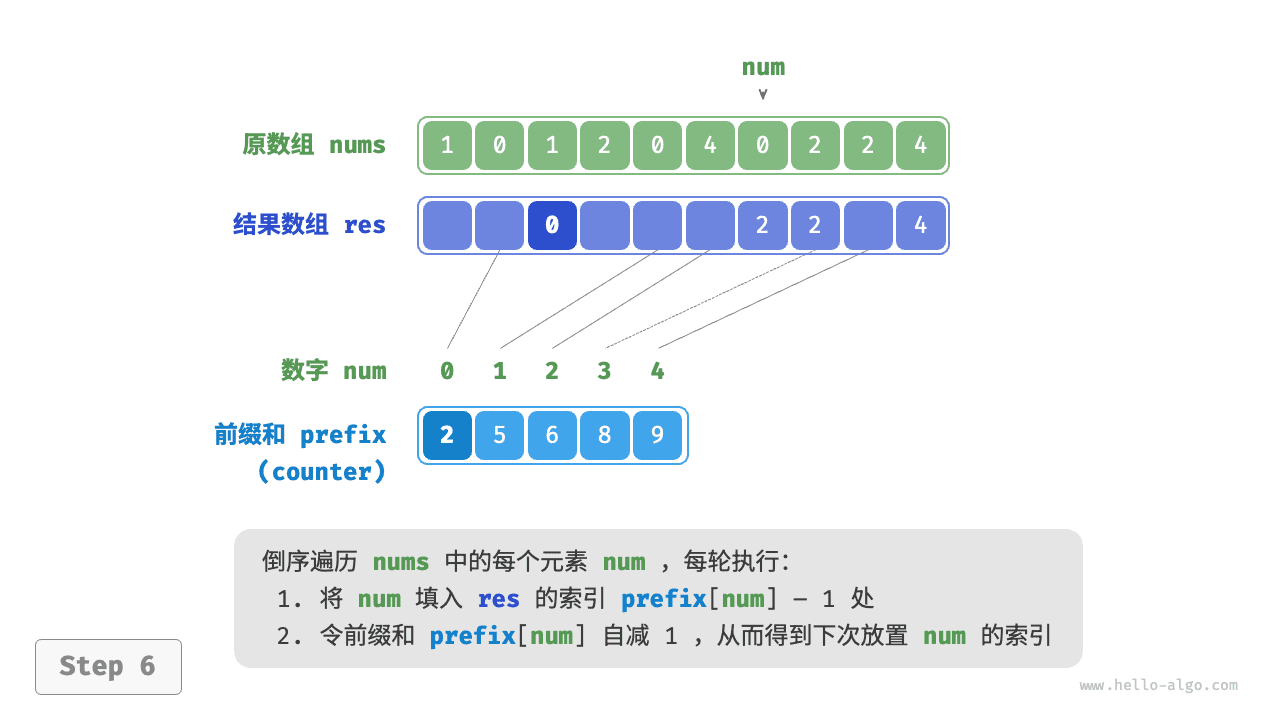
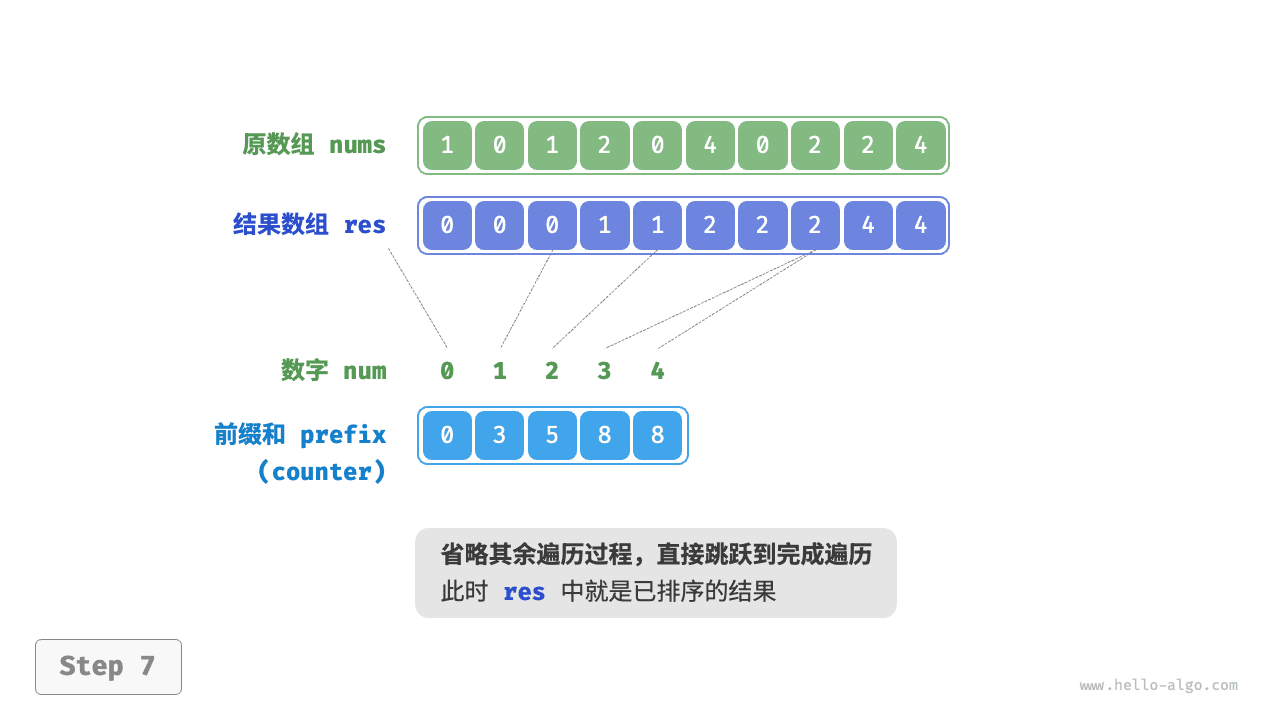
前缀和具有明确的意义,prefix[num] - 1 代表元素 num 在结果数组 res 中最后一次出现的索引。这个信息非常关键,因为它告诉我们各个元素应该出现在结果数组的哪个位置。接下来,我们倒序遍历原数组 nums 的每个元素 num ,在每轮迭代中执行以下两步。

  1. 将 num 填入数组 res 的索引 prefix[num] - 1 处。
  2. 令前缀和 prefix[num] 减小 $1$ ,从而得到下次放置 num 的索引。

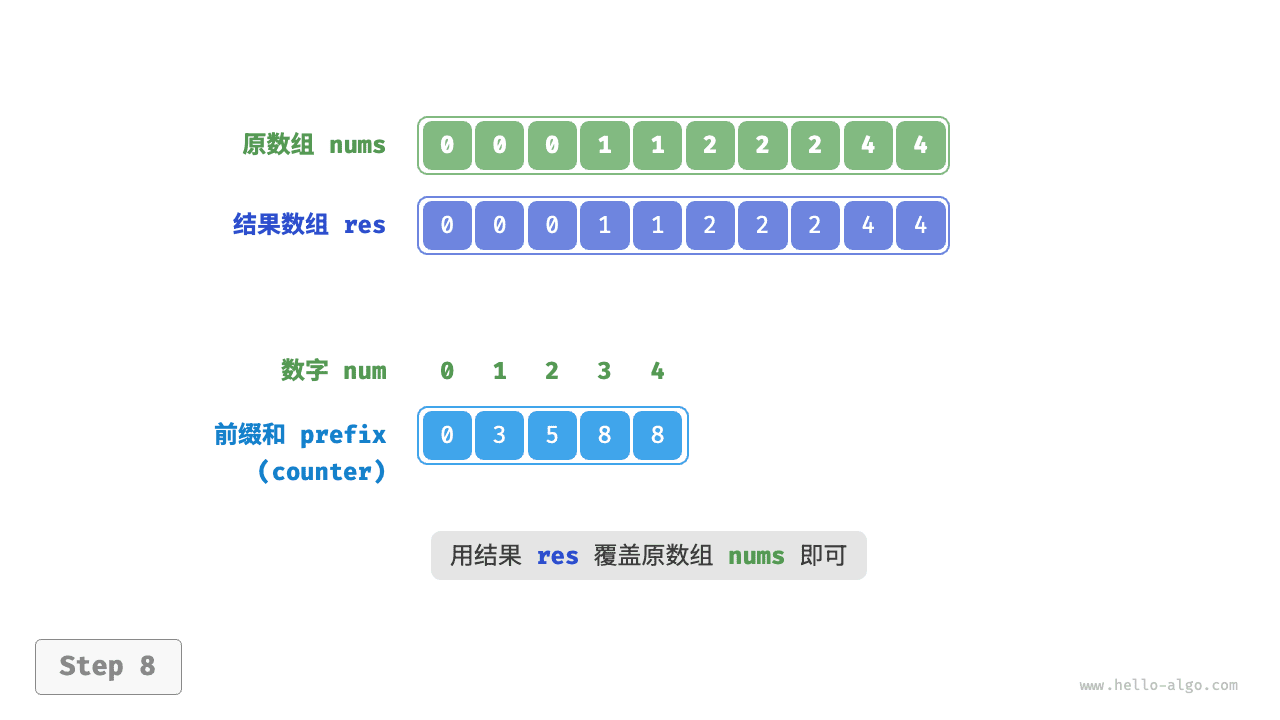
遍历完成后,数组 res 中就是排序好的结果,最后使用 res 覆盖原数组 nums 即可。下图展示了完整的计数排序流程。

=== "<1>" 计数排序步骤
=== "<2>" counting_sort_step2

=== "<3>" counting_sort_step3

=== "<4>" counting_sort_step4

=== "<5>" counting_sort_step5

=== "<6>" counting_sort_step6

=== "<7>" counting_sort_step7

=== "<8>" counting_sort_step8

计数排序的实现代码如下所示:

[file]{counting_sort}-[class]{}-[func]{counting_sort}

算法特性

  • 时间复杂度为 $O(n + m)$、非自适应排序 :涉及遍历 nums 和遍历 counter ,都使用线性时间。一般情况下 $n \gg m$ ,时间复杂度趋于 $O(n)$ 。
  • 空间复杂度为 $O(n + m)$、非原地排序:借助了长度分别为 $n$ 和 $m$ 的数组 res 和 counter 。
  • 稳定排序:由于向 res 中填充元素的顺序是“从右向左”的,因此倒序遍历 nums 可以避免改变相等元素之间的相对位置,从而实现稳定排序。实际上,正序遍历 nums 也可以得到正确的排序结果,但结果是非稳定的。

局限性

看到这里,你也许会觉得计数排序非常巧妙,仅通过统计数量就可以实现高效的排序。然而,使用计数排序的前置条件相对较为严格。

计数排序只适用于非负整数。若想将其用于其他类型的数据,需要确保这些数据可以转换为非负整数,并且在转换过程中不能改变各个元素之间的相对大小关系。例如,对于包含负数的整数数组,可以先给所有数字加上一个常数,将全部数字转化为正数,排序完成后再转换回去。

计数排序适用于数据量大但数据范围较小的情况。比如,在上述示例中 $m$ 不能太大,否则会占用过多空间。而当 $n \ll m$ 时,计数排序使用 $O(m)$ 时间,可能比 $O(n \log n)$ 的排序算法还要慢。